この記事で分かること
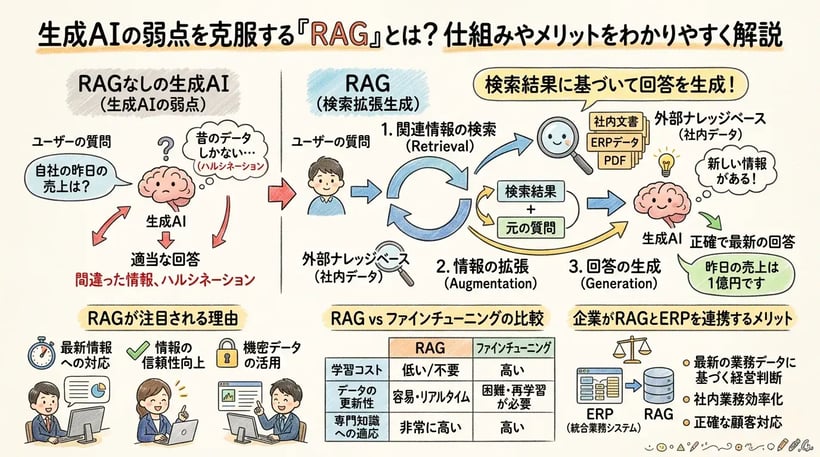
- RAG(検索拡張生成)の基本的な仕組みと注目される理由
- 生成AIの弱点であるハルシネーションを克服する方法
- RAGとファインチューニングの具体的な違い
- 企業がRAGとERPを連携して活用するメリット
ChatGPTなどの生成AIをビジネスで活用する際、事実とは異なる情報を出力する「ハルシネーション」が大きな課題となります。この弱点を補い、社内の独自データを参照した回答の精度向上を支援する技術が「RAG(検索拡張生成)」です。本記事では、RAGの仕組みやファインチューニングとの違い、企業が導入するメリットをわかりやすく解説します。さらに、RAGの真価を引き出すERPとの連携によるデータ一元管理の重要性についてもお伝えします。
生成AIのRAGとは?基礎知識と注目される背景
近年、ビジネスの現場において生成AIの活用が急速に進んでいますが、その一方で「回答の正確性」や「社内固有の情報への対応」といった課題も浮き彫りになっています。これらの課題への対応手法の一つとして注目されているのが「RAG(Retrieval-Augmented Generation:検索拡張生成)」です。
RAGとは、大規模言語モデル(LLM)に対して、外部のデータベースや情報源から検索した関連情報を与え、それをもとに回答を生成させる技術です。企業が自社の業務で生成AIを安全かつ効果的に活用する際には、RAGの仕組みを理解しておくことが有用です。
生成AIが抱えるハルシネーションなどの弱点
RAGが注目される背景には、従来の生成AIが抱えるいくつかの根本的な弱点があります。生成AIは多くの学習データをもとに自然な文章を生成できますが、出力内容が事実であることが自動的に保証されるわけではありません。
そのため、もっともらしい嘘を出力してしまう「ハルシネーション(幻覚)」と呼ばれる現象が起こり得ます。特にビジネスの意思決定や顧客対応において、不正確な情報を提供することは重大なリスクとなります。総務省の令和5年版情報通信白書などでも、生成AIの課題として偽情報の拡散やハルシネーションのリスクが指摘されています。
また、生成AIが参照できる情報はモデルや利用環境によって異なり、学習時点以降の最新情報や、あらかじめ連携されていない企業の非公開データ(社内規定、顧客情報、独自のノウハウなど)を十分に反映できない場合があります。企業が自社の業務に生成AIを組み込もうとした際、自社の独自データに基づいた正確な回答が得られないことは大きな障壁となります。
RAGの仕組みと生成AIの弱点を克服する方法
これらの課題を補う手法として活用されているのがRAGです。RAGの仕組みは、情報の「検索」と「生成」の2つのステップを組み合わせることで成り立っています。
ユーザーが質問を入力すると、RAGはまず社内のデータベースや指定された外部情報源から、質問に関連するドキュメントを検索します。次に、検索して得られた関連情報とユーザーの質問をセットにして生成AIに渡し、その情報を参照して回答を生成させます。これにより、生成AIは学習済みの情報だけでなく、検索によって取得した資料も参照しながら回答を作成できるようになります。
RAGを導入することで、具体的に以下のようなメリットが得られます。
- 社内の独自データや最新情報を踏まえた精度の高い回答が可能になる
- 参照元の情報が明確になるため、ハルシネーションのリスクを大幅に低減できる
- AIモデル自体を再学習させる必要がないため、運用コストを抑えつつ情報を常に最新に保てる
通常の生成AIとRAGを活用した生成AIの違いを整理すると、以下のようになります。
| 比較項目 | 通常の生成AI | RAGを活用した生成AI |
|---|---|---|
| 情報の鮮度 | 学習時点までの情報に限定される | データベースを更新すれば常に最新情報を参照可能 |
| 社内データの活用 | 不可(公開情報のみ) | 可能(社内規定やマニュアルなどを参照可能) |
| 回答の正確性 | ハルシネーションのリスクがある | 根拠となるデータを参照するため正確性が高い |
| 情報源の提示 | 情報源を特定できないことが多い | どの社内資料を参照したか明示できる |
このように、RAGは企業が生成AIを実業務で活用するための鍵となる技術です。自社のデータを安全かつ効果的に活用できる仕組みを整えることは、AI活用を進める上で重要な要素の一つです。
RAGとファインチューニングとの違い
生成AIを自社の業務に適合させ、回答の精度を向上させる手法として、RAG(検索拡張生成)と並んでよく比較されるのが「ファインチューニング(微調整)」です。どちらもAIのビジネス活用において重要なアプローチですが、その仕組みや適した用途は大きく異なります。自社の目的やデータ環境に合わせて最適な手法を選択するために、両者の違いを正しく理解しておくことが重要です。
ファインチューニングの仕組みと特徴
ファインチューニングとは、あらかじめ大量のデータで学習済みの生成AIモデルに対して、特定のタスクや専門分野のデータを追加で学習させ、モデル自体のパラメーター(内部の重み付け)を調整する手法です。
この手法は、特定の業界特有の専門用語のニュアンスを理解させたり、自社独自のブランドトーンに合わせた文章を出力させたりするなど、AIの「振る舞い」や「出力の形式」をカスタマイズすることに長けています。一方で、学習データに含まれない最新の情報や、日々変動する社内データを正確に回答させることには不向きです。また、モデルや手法によっては、再学習に専門的な知識や一定の計算リソース、時間を要する場合があります。
RAGとファインチューニングの比較
自社の課題を解決するために、どちらの手法を採用すべきか迷うケースは少なくありません。RAGとファインチューニングの主な違いを以下の表に整理しました。
| 比較項目 | RAG(検索拡張生成) | ファインチューニング |
|---|---|---|
| 情報のソース | 外部のデータベースや文書ファイルを参照する | AIモデル内部に学習させた知識に依存する |
| 情報の鮮度と更新 | データベースを更新するだけで即時に最新情報を反映可能 | 新しい情報を反映させるためにはモデルの再学習が必要 |
| 導入コストと期間 | 既存のAIモデルをそのまま利用するため、比較的低コスト・短期間で構築可能 | データの準備や再学習のプロセスが必要となり、高コスト・長期間になりやすい |
| 得意な領域 | 事実に基づく正確な情報検索、社内規定やマニュアルの照会 | 特定の文体での文章生成、専門的なタスクの実行、複雑な推論 |
目的に応じた最適なアプローチの選択
企業が生成AIを活用して業務効率化や意思決定の迅速化を図る場合、適した手法は目的やデータ環境、運用体制などによって異なります。
日々更新される社内データや実績数値を参照したい場合は、外部データと連携するRAGが有効な選択肢の一つです。具体的には、以下のようなケースでRAGの活用が考えられます。
- 日々更新される社内規定や業務マニュアルを社員が検索・参照するケース
- 顧客からの問い合わせに対して、過去の対応履歴や最新の製品情報を基に回答案を作成するケース
- 経営層が最新の財務データや営業成績を基に、迅速な現状把握を行いたいケース
一方で、自社特有の複雑な論理展開をAIに模倣させたい場合や、特定のフォーマットに厳密に従った出力を求める場合は、ファインチューニングが有効な選択肢となります。実際のビジネス現場においては、どちらか一方のみを採用するのではなく、AIモデルの基礎的な振る舞いをファインチューニングで調整しつつ、最新情報の取得にはRAGを組み合わせるといったハイブリッドな活用も進んでいます。
自社が抱える課題を明確にし、情報の一元管理状況や投資可能なリソースを見極めた上で、最適なAI活用のアプローチを描くことが求められます。
企業が生成AIとRAGを活用するメリット

企業が業務において生成AIを導入する際、汎用的な知識だけでなく、自社独自のノウハウや規定に基づいた回答が求められます。ここで重要となるのがRAG(検索拡張生成)の技術です。RAGを組み合わせることで、企業は生成AIの利便性を活かしつつ、業務に直結する実用的なシステムを構築できるようになります。
特に、全社的なデータ活用を目指す企業にとって、散在する社内データを適切に管理・参照できる仕組みは、意思決定の迅速化を支える要素の一つとなります。
社内データを活用した正確な情報検索
RAGを活用する主な利点の一つは、生成AIが適切に連携された自社の内部データを参照して回答を生成できる点にあります。生成AIが参照できる情報はモデルや利用環境によって異なり、あらかじめ連携されていない社内の非公開情報や最新の業務マニュアルを回答に反映できない場合があります。
しかし、RAGを導入することで、社内のファイルサーバーや文書管理システムに蓄積された過去の提案書、社内規定、製品仕様書などを検索し、その結果を基にAIが自然な文章で回答を作成します。これにより、ハルシネーションのリスクを抑え、参照データに基づく回答を得やすくなります。ただし、検索結果や参照データ、生成処理の内容によっては誤回答が生じる可能性があります。
以下の表は、一般的な生成AIと、RAGを活用した生成AIの違いを整理したものです。
| 比較項目 | 一般的な生成AI | RAGを活用した生成AI |
|---|---|---|
| 情報源 | 事前の学習データ(公開情報) | 社内データ+事前の学習データ |
| 情報の鮮度 | 学習時点までの情報 | 社内システムと連携した最新情報 |
| 回答の正確性 | ハルシネーションのリスクがある | 参照元を明示でき、正確性が高い |
| 得意領域 | 一般的な文章作成やアイデア出し | 社内規定の確認や過去事例の検索 |
このように、社内データを直接的な情報源として活用できるため、新入社員のオンボーディングや、営業担当者による過去の類似案件の検索など、多岐にわたる業務の効率化が期待できます。
セキュリティの向上と情報漏洩リスクの低減
企業が生成AIを利用する上では、セキュリティや情報漏洩のリスクが重要な検討事項となります。無料のパブリックな生成AIサービスに機密情報や顧客データを入力してしまうと、そのデータがAIの再学習に利用され、意図せず外部に漏洩してしまう危険性があります。
RAGを活用したエンタープライズ向けのAI環境を構築することで、入力したプロンプトや参照した社内データが外部の学習モデルに利用されることを防ぐことができます。中小企業の情報セキュリティ対策ガイドラインなどでも、機密情報の取り扱いには適切な環境構築やルール策定が推奨されています。
RAGの導入によってもたらされるセキュリティ面のメリットは、主に以下の点が挙げられます。
- 入力データや社内文書がAIの外部学習に利用されない閉域環境の構築
- 社内のアクセス権限設定と連携し、役職や部門に応じた情報のみを回答させる制御
- AIがどの社内文書を参照して回答したかという根拠(ソース)の追跡と検証
特に、アクセス権限との連携は重要です。適切な認証・認可やアクセス制御を実装することで、機密性の高い財務データや人事情報が権限のない利用者に提示されるリスクを低減できます。これにより、ガバナンスに配慮しながら、生成AIを組織内で活用しやすくなります。
RAGの真価を引き出すERPの重要性
生成AIとRAGの組み合わせは、社内データを参照しながら回答精度の向上を目指せる仕組みです。しかし、その回答の質は「参照するデータの質と網羅性」に大きく依存します。ここで選択肢の一つとなるのが、複数の基幹業務データを統合・管理するERP(統合基幹業務システム)です。
部門最適から全社最適へ導くデータの一元管理
企業によっては、会計パッケージや販売管理システム、部門ごとのExcelファイルなどにデータが分散し、「サイロ化」が生じている場合があります。このような状態でRAGを導入すると、参照対象が一部のデータに限られ、経営層や部門責任者が必要とする横断的な情報を十分に反映できない場合があります。実際に、総務省が公表している令和5年版情報通信白書などでも、企業がデジタル化やデータ利活用を進める上での課題として、システム間の連携不足やデータのサイロ化が指摘されています。
ERPの導入・刷新などによって、財務、人事、生産、販売などの業務データを統合・管理することで、RAGが複数部門の情報を参照しやすい環境を整えられます。部門ごとに分散したデータを整理・連携することは、RAGの回答精度や活用範囲を改善するための基盤の一つとなります。
- 各部門に散在するデータを統合し、単一の信頼できる情報源を確立する
- リアルタイムなデータ更新により、生成AIが常に最新の状況を踏まえた回答を生成する
- データフォーマットが統一されることで、RAGによる情報検索の効率と精度が向上する
ERPと生成AIの連携による経営の見える化
ERPなどで統合されたデータと、RAGを備えた生成AIを適切に連携することで、企業の「経営の見える化」を支援できる可能性があります。システムを適切に構成することで、経営層や事業責任者が自然言語で質問し、ERP内のデータから関連情報を検索・整理できるようになります。分析結果については、データ品質やシステム構成に応じた検証が必要です。
例えば、「今月の事業部ごとの予実差異は何か」といった問いに対して、適切なデータ連携や分析機能を備えていれば、生成AIがERP内の財務データや販売実績を参照し、情報を整理して提示できる場合があります。これにより、データ収集や集計に多大な時間を費やすことなく、迅速かつデータドリブンな意思決定が可能になります。
| 従来のシステム環境 | ERP×生成AI(RAG)環境 |
|---|---|
| 部門ごとにデータが分断され、集計に多大な時間と手間がかかる | 全社データが一元管理され、リアルタイムな情報把握が可能 |
| 専門的な知識を持つ担当者でなければデータ分析が難しい | 自然言語による質問で、誰でも容易にインサイトを引き出せる |
| 過去のデータに基づく事後的な状況確認にとどまる | 最新データを踏まえた迅速な意思決定と将来予測が実現する |
このように、ERPは業務効率化に加え、生成AIが参照するデータを統合・管理する基盤の選択肢の一つとして活用できます。RAGの導入を検討する際は、自社のデータ基盤や運用体制を見直し、必要に応じてERPを含むデータ統合基盤の導入や刷新を検討することが有効です。
生成AI RAGの導入に向けたステップと注意点
生成AIとRAGを組み合わせて業務効率化や経営の見える化を進める際は、目的や運用体制に応じて計画的に導入を進めることが重要です。ここでは、具体的な導入手順と、プロジェクトを成功に導くための注意点を解説します。
RAG導入に向けた具体的なステップ
RAGの導入は、単にAIツールを契約して終わりではありません。社内の情報資産を適切に活用し、全社最適を図るためには以下のステップで進めることが推奨されます。
- 目的の明確化と対象業務の選定
- 社内データの整備と一元化
- システムの構築と検証
- 全社展開と継続的な運用
1. 目的の明確化と対象業務の選定
まずは、RAGを活用してどのような経営課題を解決するのかを明確にします。「社内の規定や過去の提案書を迅速に検索したい」「経営指標に関する問い合わせ対応を自動化したい」など、具体的なユースケースを洗い出し、費用対効果が見込める業務から優先順位をつけます。
2. 社内データの整備と一元化
RAGの回答品質は、参照するデータの質や網羅性、検索方式、モデルの性能など複数の要素に影響されます。部門ごとにExcelが乱立していたり、システムがサイロ化していたりする状態では、AIが正確な情報を引き出すことは困難です。そのため、必要なデータを適切に整理・管理し、更新状況や正確性を確認できるデータ基盤づくりが重要になります。
3. システムの構築と検証
整備されたデータを基にRAGシステムを構築し、一部の部門や業務に絞ってテスト運用(PoC)を行います。期待した回答が得られるか、検索スピードは十分かなどを検証し、プロンプトや検索アルゴリズムの調整を繰り返します。
4. 全社展開と継続的な運用
テスト運用で効果が確認できたら、対象業務を拡大して全社展開を進めます。導入後も、社内データの更新やユーザーからのフィードバックをもとに、継続的にシステムを改善していく体制が求められます。
RAG導入時に押さえておくべき注意点
RAGは強力な仕組みですが、導入にあたってはいくつかの注意点が存在します。以下の表に、主な注意点と対策を整理しました。
| 注意点 | 具体的なリスクと対策 |
|---|---|
| データ品質の確保 | 不正確なデータや古い情報が混在していると、AIの回答精度が著しく低下します。情報の鮮度と正確性を担保するためには、場当たり的なファイル管理から脱却し、統合的なシステムによるデータ管理が不可欠です。 |
| セキュリティとアクセス制御 | 経営層のみが閲覧できる機密情報が、一般社員の質問に対して回答されてしまうリスクがあります。ユーザーの役職や所属部門に応じた厳密なアクセス権限の設定と、それを制御できるシステム基盤が必要です。 |
| ハルシネーションへの対策 | RAGを用いても、AIが事実と異なる回答を生成するリスクをゼロにはできません。回答の根拠となる社内ドキュメントの参照元を明示する仕組みを取り入れ、最終的には人間が内容を確認するプロセスを設けることが重要です。 |
RAGを効果的に活用するためには、AIツールの導入だけでなく、必要に応じてデータ基盤や運用体制の見直しを行うことが有効です。部門最適から全社最適へと移行する基盤づくりは、プロジェクトを進める上で重要な要素の一つです。
現在、部門ごとのシステムやExcel管理に限界を感じている場合は、AI活用を見据えたデータ基盤の整備を検討する良い機会です。まずは自社のデータ管理状況を見直し、全社最適を実現するERPの概要や最新の導入事例に関する資料を調査することから始めてみてはいかがでしょうか。
生成AIとRAGに関するよくある質問
RAGはどのようなデータを参照できますか?
システムが対応している形式で、適切に取り込み・検索対象として設定されたPDF文書、マニュアル、社内Wiki、データベースなどを参照できます。
RAGの導入にはプログラミングの知識が必要ですか?
自社でゼロから構築する場合は専門知識が必要ですが、既存のクラウドサービスやツールを利用すればプログラミング不要で導入できることもあります。
RAGとファインチューニングはどちらを選ぶべきですか?
社内の最新情報や特定の文書に基づいた回答を求める場合はRAGが適しており、AIの出力形式や専門的なタスクに特化させたい場合はファインチューニングが適しています。
RAGを利用する際のセキュリティリスクはありますか?
外部の生成AIモデルに機密データを送信する際の情報漏洩リスクが考えられますが、エンタープライズ向けのセキュアな環境を利用することでリスクを低減できます。
RAGを導入すればハルシネーションは完全に無くなりますか?
RAGによってハルシネーションのリスク低減が期待できますが、参照元のデータが不正確な場合や検索・生成処理の問題などにより、誤った回答が生じる可能性は残ります。
まとめ
生成AIのRAGとは、社内データなどの外部情報を検索し、その結果を参照して回答を生成することで、ハルシネーションなどの課題を軽減することを目指す仕組みです。RAGを適切なセキュリティ対策と組み合わせることで、企業は社内データを参照した情報検索や回答生成に活用できます。また、RAGを効果的に活用するためには、ERPを含むデータ統合・管理の仕組みを必要に応じて検討することが有効です。部門ごとに分散したデータを整理・連携し、ERPなどの統合されたデータをRAGから参照できるようにすることで、経営情報の把握を支援できる可能性があります。生成AIの活用を検討する際は、まずは基盤となるERPの導入や見直しについて情報収集を始めてみてはいかがでしょうか。